Le détecteur se trompe avec régularité
Un détecteur d'IA reçoit un texte fini et devine. Il observe la longueur des phrases, le choix des mots, la prévisibilité, et en déduit une origine. La méthode a un défaut intégré : plus quelqu'un écrit avec soin, plus le texte devient lisse. Reprendre dix fois un paragraphe jusqu'à ce que chaque phrase tienne, c'est produire exactement la régularité qu'un détecteur lit comme machinale.
Les personnes qui écrivent dans une langue seconde sont les plus touchées. Leur vocabulaire est plus délibéré, leur syntaxe plus prudente — et les détecteurs les signalent de façon disproportionnée. Les témoignages d'étudiants dont le travail personnel a été classé ainsi sont désormais trop nombreux pour être écartés comme des cas isolés.
Le problème de fond : un texte fini ne garde aucune mémoire de sa fabrication. On ne peut pas voir s'il a grandi en trois semaines ou s'il a été généré en trois secondes. Le détecteur déduit l'histoire de la surface — et une déduction reste une déduction, quelle que soit l'assurance du pourcentage affiché.
Les filigranes arrivent — et répondent à la mauvaise question
Le filigranage n'est plus hypothétique. Google marque déjà les sorties de ses modèles Gemini avec SynthID, Anthropic a annoncé qu'il marquerait l'ensemble des sorties de ses modèles — sous l'effet des exigences de transparence de l'AI Act européen — et d'autres fournisseurs suivront. Qui écrit avec l'IA recevra du texte marqué, qu'il le veuille ou non.
Deux points sont régulièrement sous-estimés. Ces marques sont invisibles et indétectables sans l'outil dédié du fournisseur concerné. Et elles sont plus robustes qu'on ne le croit : parce qu'elles sont intégrées statistiquement dans la structure du texte, elles survivent au copier-coller et à toute une série de modifications.
Le vrai problème est ailleurs — et pour les auteurs il est dangereux.
Un filigrane marque la sortie, pas la contribution. Anthropic indique que chaque sortie est marquée. Si vous confiez au modèle un paragraphe que vous avez écrit vous-même et lui faites corriger un seul mot, vous récupérez l'intégralité du paragraphe marquée. Le texte est presque entièrement le vôtre — et porte la même marque qu'un texte entièrement écrit par la machine.
La méthode ne mesure donc pas la paternité mais le contact. Tout contact. Et étant binaire, elle ne connaît aucune gradation entre « je l'ai écrit et j'ai fait corriger une faute de frappe » et « c'est la machine qui l'a écrit ».
Pour le groupe le plus nombreux — celles et ceux qui écrivent eux-mêmes et recourent ponctuellement à l'IA — c'est la pire nouvelle possible. Ils posséderont du texte marqué sans s'en apercevoir, sans pouvoir le retirer, et sans rien avoir à y opposer.
Ce n'est pas un argument contre le filigranage. Pour son objectif propre — rendre identifiables à grande échelle les contenus produits par machine — il est pertinent, et l'AI Act européen a de bonnes raisons de l'exiger. Il ne peut simplement pas répondre à la seule question qui compte pour un auteur : non pas si un modèle est intervenu, mais dans quelle mesure.
C'est précisément pourquoi il faut la direction inverse.
Nous documentons plutôt la genèse
Hermes 3000 ne devine pas. Nous enregistrons pendant que l'écriture a lieu.
Quand notre serveur produit un texte — une génération, une reformulation, une transcription de dictée —, il le sait. Il n'a pas à le déduire. Il conserve ce qu'il a remis et vérifie, à l'enregistrement suivant, quelle part a atterri dans le manuscrit et quelle part l'auteur a depuis réécrite. S'y ajoute ce que seul l'éditeur peut savoir : si le texte a été tapé ou s'il est apparu d'un bloc, et combien de temps quelqu'un a réellement travaillé sur un passage.
La différence décisive : ce n'est pas une analyse du résultat mais un enregistrement du processus. C'est pourquoi il survit à la réécriture — mieux, la réécriture est elle-même une information que l'on conserve.
Et le texte venu de l'extérieur ?
Il existe exactement un cas dont le relevé ne sait rien : le texte collé ou importé. Il vient d'ailleurs — cela peut être votre propre texte issu d'un autre document, une citation, la sortie d'un autre outil d'IA. L'éditeur voit seulement que 1 800 caractères sont soudain là, qui n'y étaient pas avant.
Plutôt que de deviner, nous demandons.
Collez un passage conséquent et, peu après, une petite notification apparaît avec un bouton : d'où viennent ces caractères ? Pas une boîte de dialogue qui interrompt l'écriture — une proposition qui disparaît d'elle-même au bout de quinze secondes. À l'import d'un manuscrit, la question est posée une fois, juste après, tant que l'on sait encore ce que l'on vient d'importer.
Les options sont celles qui se présentent réellement : écrit par moi (ailleurs), par une autre personne, issu d'un autre outil d'IA, cité d'une source, domaine public. Avec une remarque facultative.
Trois propriétés nous importent ici :
La question porte sur un événement concret. « D'où viennent ces 1 833 caractères ? » admet une réponse. « Quelle part d'IA y a-t-il dans votre livre ? » non — c'est pourquoi la question est attachée au collage et à l'import, et non à un formulaire dans les réglages.
« Plus tard » est une vraie réponse. Le bouton pour différer a le même poids que celui pour répondre. Qui ne veut pas répondre ne doit pas être poussé à une déclaration fausse. La question reste ouverte et l'attestation l'indique comme non déclarée.
Et une déclaration ne devient jamais une mesure. Elle figure dans un champ distinct de l'attestation, explicitement présentée comme la déclaration de l'auteure, et le document signé nomme les deux : combien de caractères reposent sur une déclaration — et combien sont venus de l'extérieur sans avoir jamais été déclarés. Une attestation qui laisserait passer une affirmation pour une preuve vaudrait moins qu'une attestation qui admet le manque.
À l'import, la réponse vaut pour l'ensemble du manuscrit et les passages en héritent — on explique un livre, pas quatre cents passages.
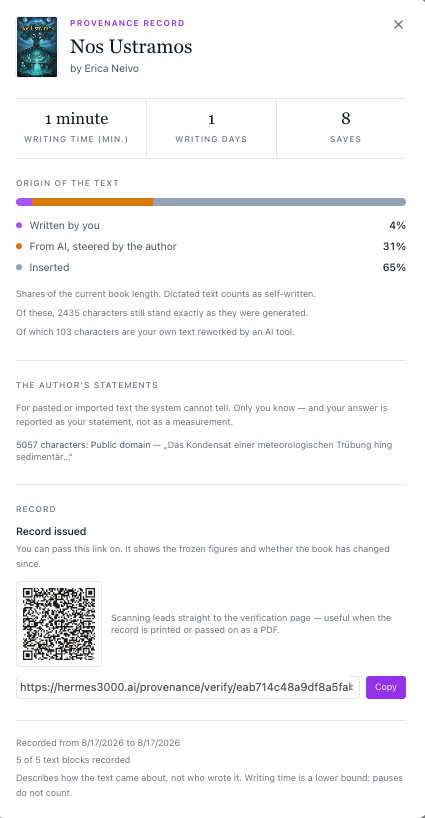
À quoi cela ressemble : la répartition par origine, la déclaration sur le texte inséré — et l'attestation émise avec un lien vérifiable et un QR code.
Pourquoi c'est meilleur pour les trois groupes
Celles et ceux qui écrivent tout eux-mêmes
Ce groupe est aujourd'hui dans la situation la plus absurde : rien à cacher, et rien à montrer. Quand un détecteur signale leur manuscrit, il ne leur reste qu'à protester. Une attestation de provenance renverse la charge — non pas « je jure que c'était moi », mais un relevé montrant que le texte a grandi par petites étapes pendant des semaines. Qui n'utilise l'IA que pour demander un avis sur un passage le voit exactement ainsi : une question posée, aucune trace dans le texte.
Les hybrides — le groupe le plus nombreux
La plupart travaillent ainsi : écrire soi-même, faire reformuler une phrase de temps en temps, générer parfois un passage puis le retravailler en profondeur. Pour cette réalité, il n'existe pas encore de langage. « Avec IA ou sans ? » n'a pour eux aucune réponse honnête, et chaque case oui/non les force à une déclaration fausse.
Une attestation peut exprimer exactement ce qui s'est passé : ce paragraphe est de vous, un outil en a lissé 300 caractères. Celui-là vient d'une génération, et vous en avez réécrit les deux tiers. Ce n'est pas de la dilution, c'est de la précision.
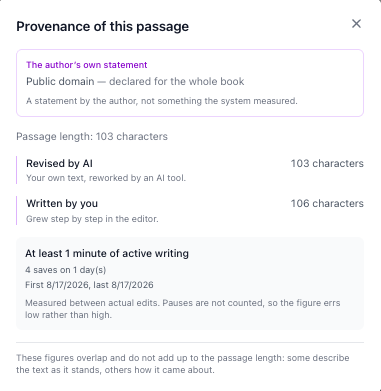
Jusqu'au passage isolé — avec la mention explicite que les valeurs se recoupent et ne totalisent pas la longueur du passage.
Celles et ceux qui travaillent largement avec l'IA
Là aussi le détail compte — et c'est peut-être la partie la plus surprenante. Entre « écris le chapitre 3 » et un livre nourri de personnages élaborés, d'une intrigue réfléchie, de compétences de style choisies et de huit variantes essayées par scène, il y a un monde. Les deux résultats sont générés par IA. Sauf que l'un a pris deux minutes et l'autre de nombreuses heures.
Pour le texte issu de l'IA, nous distinguons donc si une personne l'a dirigé : régénéré plusieurs fois, rédigé une consigne propre au lieu d'un simple titre de chapitre, ou retravaillé le résultat à la main. Qui fait cet effort a façonné le texte de manière causale — simplement pas au clavier. Un filigrane n'en voit rien. Un détecteur encore moins.
Et pour tous ceux qui travaillent à plusieurs
Un livre se fait rarement seul. Correction, coaching, mentorat, une co-autrice — chacune de ces mains laisse des traces indiscernables dans un texte fini. Parce que nous enregistrons pendant l'écriture, la chronologie subsiste : quand telle partie est arrivée, combien elle a été retravaillée ensuite, sur combien de jours.
Pour les programmes de coaching et les ateliers d'écriture, c'est l'application vraiment intéressante. Non comme surveillance, mais comme preuve du travail accompli.
Ce qu'est un Verifiable Credential — et pourquoi il convient ici
Des chiffres affichés dans son propre outil sont vite affirmés. Cela devient intéressant quand un éditeur peut les vérifier sans nous faire confiance.
C'est à cela que servent les Verifiable Credentials, un standard du W3C. Un émetteur — ici Hermes 3000 — place une affirmation dans un document et le signe cryptographiquement avec sa clé privée. Quiconque dispose de la clé publique correspondante peut vérifier que le document vient bien de cet émetteur et que pas un caractère n'a changé depuis. Pas de registre central, pas de compte, pas d'appel chez nous.
Concrètement : l'auteure émet l'attestation, les valeurs sont figées et signées, elle reçoit un lien et un QR code. L'éditeur ouvre le lien — sans connexion — et voit les valeurs signées, ainsi qu'une note indiquant à quel point le livre a changé depuis. Qui le souhaite vérifie la signature avec des outils standards plutôt que de croire notre coche verte.
Pourquoi cela convient si bien ici : une attestation de provenance est une affirmation sur un instant. Elle doit être figée, sinon elle décrit un autre livre à la deuxième ouverture. Elle doit être vérifiable sans que le vérificateur ait à faire confiance à l'émetteur. Et elle doit pouvoir être retirée si quelque chose s'avère faux. Le standard apporte exactement ces trois propriétés.
Ce que nous nous gardons d'affirmer
Une attestation ne vaut que ce qu'elle dit de ses propres limites. C'est pourquoi ceci figure sur la page de vérification et dans le document signé lui-même :
La signature atteste que Hermes a enregistré ce processus ainsi — non que le relevé soit complet, et encore moins de qui viennent les idées. Recopier à la main un texte d'IA depuis une autre application déjoue la mesure ; cela ne peut pas être détecté, et nous le disons. Le temps d'écriture indiqué est une borne inférieure : réfléchir sans frapper une touche ne compte pas. Et ce qui a été inséré de l'extérieur, seule l'auteure peut l'expliquer — ces réponses sont explicitement présentées comme sa déclaration, jamais comme une mesure.
Nous n'y voyons pas une faiblesse mais la condition sous laquelle une telle attestation vaut quelque chose. Un sceau qui promet plus qu'il ne peut tenir dépense précisément la confiance qu'il devrait créer.
Pourquoi il en faudra davantage
Le débat converge vers la mauvaise question. « Ce texte est-il de l'IA ? » n'admet ni oui ni non chez la plupart des gens qui travaillent sérieusement — et une méthode qui impose malgré tout une réponse se trompera systématiquement. Le plus souvent au détriment de ceux qui travaillent avec le plus de soin.
La meilleure question est : comment ce texte est-il né ? Elle est répondable, elle est attestable, et elle rend justice à la réalité dans laquelle la plupart écrivent aujourd'hui. Les éditeurs, les universités et les plateformes auront besoin de telles attestations — non par méfiance envers les personnes, mais parce qu'il leur faut une base plus solide que l'intuition d'un classificateur.