Jeder Roman hat eine Frage, die sich mit dem Manuskript nicht beantworten lässt, solange man drinsteckt: Hält das Buch seine Spannung? Trägt der Konflikt aus Kapitel drei bis zur Mitte, oder sackt da etwas ab, das man beim Schreiben nicht gemerkt hat, weil jedes Kapitel für sich genommen gut war? Lektorinnen und Lektoren beantworten diese Frage, indem sie das Ganze am Stück lesen. Wer allein schreibt, hat diese Lesung nicht.
Seit dieser Woche zeigt Hermes 3000 bei Romanen oben im Editor eine kleine Kurve: die Spannungskurve. Sie ist so breit wie das geplante Buch, geschriebene Kapitel füllen sie von links, und ein Klick öffnet, was dahintersteckt. In diesem Artikel erklären wir, wie die Kurve entsteht, warum wir die KI dabei bewusst nicht nach einer Zahl fragen, was ein Decision Model ist und wo die Grenzen liegen. Wer nur sehen will, wie es aussieht, scrollt zum Video.
Was die Kurve zeigt
Im Kopf des Editors, neben dem Schreibfortschritt, liegt eine Pille mit einer Linie. Die Linie ist die Spannung je Kapitel, das Maximum aus innerer und äußerer Spannung, über die ganze Länge des Buchs, so wie es in deiner Kapitelstruktur geplant ist. Was geschrieben ist, trägt die Linie; was noch fehlt, ist eine gepunktete Spur. Bei einem halb geschriebenen Roman ist die Kurve halb gefüllt. Sie ist also zugleich eine Fortschrittsanzeige, und sie entsteht von selbst: Öffnest du ein Buch, dessen Kurve fehlt, läuft die Analyse im Hintergrund an, und die Kurve wächst Kapitel für Kapitel in eine kleine Welle hinein.
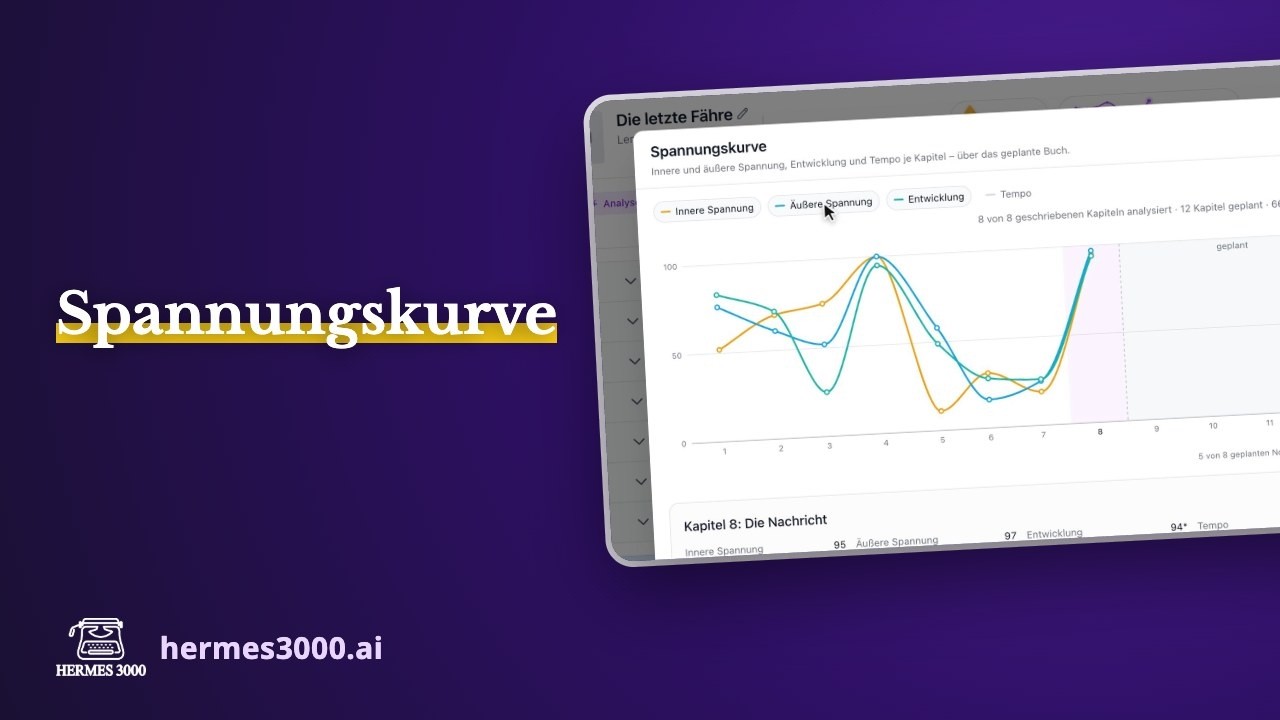
Ein Klick öffnet das Panel mit drei Linien:
- Innere Spannung: Konflikt zwischen Figuren oder in einer Figur. Ein Streit, ein verwehrter Wunsch, eine Lüge, ein Dilemma, ein Verlust, Widersacher, die aufeinandertreffen.
- Äußere Spannung: Einsatz, der aus Welt und Handlung kommt. Körperliche Gefahr, Gewalt, Flucht oder Verfolgung, eine Frist, eine Bedrohung, eine Enthüllung, eine Entscheidung ohne Rückweg.
- Entwicklung: wie viel sich in einem Kapitel bewegt. Hat sich die Lage einer Hauptfigur am Ende verändert, wie viele Fäden wurden eröffnet und aufgelöst, wie viele Ereignisse und Figurenentwicklungen zählt der Story Atlas.
Dazu, abschaltbar, das Tempo: Dialoganteil und Satzlänge, gezählt, nicht beurteilt. Unter der Grafik steht das Kapitel, auf dem die Maus liegt, mit seinen Werten und den Signalen dahinter: „Offener Konflikt 98“, „Verheimlichung 85“, „Zeitdruck 71“. Darunter wenige Beobachtungen zum Verlauf, zum Beispiel: „Seit Kapitel 2 (Spannung 100) fällt die Kurve, Kapitel 3 liegt bei 59. Geht es so weiter, droht in der Mitte des Buchs ein Durchhängen.“
Warum wir die KI nicht nach einer Zahl fragen
Der naheliegende Weg wäre, einem Sprachmodell jedes Kapitel zu zeigen und zu fragen: Wie spannend ist das, von eins bis zehn? Wir haben das in Hermes seit Monaten, in der Qualitätsanalyse, die elf Dimensionen eines Kapitels bewertet, darunter Spannung. Eine Kurve haben wir daraus nie gebaut, und der Grund ist messbar: Die Zahlen rauschen. Dasselbe Kapitel bekommt heute eine sieben und morgen eine fünf, Nachbarkapitel springen ohne erkennbaren Grund, und ein Modell, das ein Kapitel isoliert sieht, hat keine stabile Skala.
Das ist kein Hermes-Problem, sondern ein Befund der Forschung. Glenn Matlin und Kollegen von der Georgia Tech haben 2025 vier klassische Studien aus der Psychologie des Spannungsempfindens nachgestellt, mit zehn Sprachmodellen anstelle der menschlichen Versuchspersonen (Do Language Models Agree with Human Perceptions of Suspense in Stories?, COLM 2025). Ergebnis: Bei der Frage, ob ein Text Spannung anlegt, sind die Modelle brauchbar; die Autoren nennen sie „quite competent“. Bei der Frage, wie viel Spannung ein Leser empfindet, versagen sie, besonders an den Wendepunkten, also genau dort, wo es interessant wird. Textmanipulationen, die bei Menschen die Spannung senken würden, ändern die Bewertung der Modelle kaum. Die Modelle lesen Hinweise im Abschnitt, aber sie bauen kein Modell der Geschichte.
Die Konsequenz für uns war klar: Fragen, was Modelle können, und das andere selbst rechnen.
Das Modell transkribiert, der Code urteilt
Statt einer Zahl stellen wir dem Modell für jedes Kapitel achtzehn Ja/Nein-Fragen über beobachtbare Dinge. Zum Beispiel:
- Tragen zwei oder mehr Figuren in diesem Kapitel einen offenen Konflikt aus: einen Streit, einen Vorwurf, eine Konfrontation, einen Kampf?
- Will eine Figur etwas von einer anderen (Liebe, Zustimmung, Hilfe, Vergebung, Nähe) und bekommt es in diesem Kapitel nicht?
- Verheimlicht eine Figur einer anderen, die im Kapitel vorkommt, absichtlich etwas Wichtiges, oder belügt sie sie?
- Ist eine Figur in konkreter körperlicher Gefahr?
- Treibt eine Frist, ein Ultimatum oder ein Wettlauf gegen die Zeit die Handlung?
- Trifft eine Figur eine Entscheidung, die sich nicht rückgängig machen lässt?
- Endet das Kapitel an einer offenen Frage, einer Unterbrechung oder einem bevorstehenden Ereignis?
- Ist die Lage einer Hauptfigur am Ende des Kapitels wesentlich anders als am Anfang?
Dazu kommen zwei Fragen mit drei Stufen, als Anker je Achse: Wie intensiv sind die Konflikte zwischen oder in den Figuren, nicht vorhanden, latent oder offen ausgetragen? Wie hoch steht der äußere Einsatz, nichts, angedeutet oder akut?
Das Modell antwortet auf jede Frage mit einer Wahrscheinlichkeit. Alles Weitere ist Arithmetik, die in unserem Code steht und nicht im Modell: Der Wert einer Achse ist zur Hälfte die Stufenfrage und zur Hälfte die gewichtete Summe der Prädikate, die bei zwei starken Signalen sättigt. Ein Kapitel mit einem Streit und einem Verrat ist nicht doppelt so spannend wie eines mit einem Streit, es ist oben auf der Skala. Diese Entscheidung kann man diskutieren, ändern und testen, und sie ändert sich nicht von Lauf zu Lauf.
Der schönste Nebeneffekt: Die Signale sind die Erklärung. Ein Punkt auf der Kurve sagt nicht „73“, er sagt „Offener Konflikt, Verheimlichung, verwehrtes Begehren“. Das ist, womit eine Autorin arbeiten kann.
Das Prinzip ist nicht neu für uns. Unsere Normprüfung für Gesetzestexte funktioniert genauso: Das Modell überträgt die zeitliche Struktur eines Gesetzes in eine Tabelle, jede Zeile mit wörtlichem Zitat, und Code entscheidet, ob eine Lücke vorliegt. Ein Modell, das Fehler suchen soll, erfindet welche; ein Modell, das nur transkribiert, lässt sich prüfen.
Was ein Decision Model ist, und warum es hier passt
Fragen mit Ja oder Nein beantworten kann jedes Sprachmodell. Aber es antwortet mit Text, den man parsen muss, es formuliert um, es gibt manchmal keine Antwort, und seine „Wahrscheinlichkeit“ ist eine Zahl, die es eben hinschreibt. Seit September 2026 gibt es dafür eine eigene Modellklasse: Decision Models. Das Startup TypeSafe hat mit Jev die Kategorie eröffnet, OpenAI hat auf der DevDay am 29. September die Decisions API angekündigt und sie am 22. Oktober für alle freigegeben, Cloudflare hat mit Clef Modelle mit offenen Gewichten nachgelegt.
Die Idee: Das Modell liest die Eingabe und alle Fragen in einem Durchgang und gibt für jede Frage eine Wahrscheinlichkeit zurück, keinen Text. Drei Fragetypen: eine Aussage, die wahr oder falsch ist; eine Auswahl aus benannten Optionen; eine Einordnung auf einer beschriebenen Stufenleiter. Die Antworten sind in Form garantiert, es gibt nichts zu parsen, und die Modelle sind auf Kalibrierung trainiert: Wenn das Modell bei hundert Fragen „70 Prozent“ sagt, sollte es etwa siebzigmal recht haben. Das ist der Punkt, an dem eine Zahl aus einem Chat-Modell und eine Zahl aus einem Decision Model sich unterscheiden.
Hermes nutzt die Decisions API von OpenAI, nicht direkt, sondern über den Gateway unserer Schwesterfirma HybridAI, der sie mit europäischer Regionalverarbeitung weiterreicht. Alle zwanzig Fragen zu einem Kapitel laufen in einem einzigen Aufruf; ein Kapitel von vierzig Normseiten kostet etwa einen Viertelcent und dauert eine bis zwei Sekunden. Unverändert gebliebene Kapitel kosten nichts, weil die Antworten am Textinhalt gespeichert werden. Fällt der Gateway aus, springt ein gewöhnliches Sprachmodell ein und antwortet als JSON; das Panel markiert solche Kapitel als „Ersatzmodell“, weil die Zahlen dann nicht kalibriert sind.
Eine Einschränkung gehört dazu, und OpenAI sagt sie selbst: Hinter der Decisions API steht derzeit „plain old Luna“, also das normale GPT-6 Luna in einem anderen Ausgabemodus, kein eigens trainiertes Urteilsmodell. Ein Paper über Jev im Vergleich mit LLM-Richtern trägt den Titel Cheaper, Faster, and Wrong in the Same Places. Das Decision Model löst das Formproblem, kalibrierte Zahlen ohne Parsen, es löst nicht das Urteilsproblem. Genau deshalb bleiben unsere Fragen beobachtbar und die Skala bei uns.
Entwicklung und Tempo: was sich zählen lässt, wird gezählt
Zwei der vier Linien brauchen kaum ein Modell. Das Tempo kommt aus Satzlänge und Dialoganteil, gemessen über den ganzen Text, für jedes Kapitel, ohne Aufruf. Das ist nicht Spannung, ein ruhiger Dialog liest sich auch schnell, aber es ist die eine Linie, die sich bis auf den Absatz hinunter messen lässt.
Die Entwicklung kombiniert ein Prädikat („Lage verändert“) mit dem, was der Story Atlas ohnehin über ein Kapitel weiß: welche Handlungsfäden es eröffnet und welche es auflöst, wie viele Ereignisse es enthält, welche Figuren sich verändern. Wer den Atlas-Scan laufen lässt, bekommt eine vollständigere Entwicklungslinie; ohne ihn trägt das Prädikat allein, und das Panel sagt das mit einem Sternchen.
Hier liegt auch die Forschung, die wir als Nächstes anzapfen wollen. Olivier Toubia, Jonah Berger und Jehoshua Eliashberg haben 2021 in PNAS gezeigt, wie man die Form einer Geschichte aus Spracheinbettungen misst: die Geschwindigkeit, mit der sich der Text durch den Bedeutungsraum bewegt, das Volumen, das er dabei abdeckt, und wie verschlungen sein Weg ist. Eine Studie vom Februar 2026 hat das auf 28.606 Bücher angewendet und gefunden, dass das Volumen der stärkste längenunabhängige Prädiktor dafür ist, wie oft ein Buch gelesen wird. Diese Maße sind deterministisch und kostenlos, und sie wären eine gezählte zweite Quelle für die Entwicklungslinie.
Die x-Achse ist das Buch, nicht der Kapitelindex
Ein Detail, das bei Kurven dieser Art fast immer falsch gemacht wird: Ein Kapitel von vierzig Seiten mit einem Streit in der Mitte und ein Kapitel von fünf Seiten, das nur aus Streit besteht, sehen als zwei gleich breite Punkte gleich aus. Unsere x-Achse ist deshalb die Position im Buch in Normseiten. Jedes Kapitel ist so breit, wie es lang ist. Eine Durststrecke von drei kurzen Kapiteln ist kurz, eine von drei langen ist lang, und die Kurve sagt das ehrlich.
Kapitel, die in der Struktur stehen, aber noch keinen Text haben, bekommen die mittlere Breite der geschriebenen. So endet die Achse dort, wo das Buch enden soll, und die Füllung von links ist der Fortschritt. Die meisten Bücher, auf denen die Kurve laufen wird, sind unfertig; wir haben sie für diesen Zustand gebaut, nicht für das Regal.
Beobachtungen statt Note
Es wäre leicht gewesen, eine Idealkurve darüberzulegen, die Drei-Akt-Struktur oder die Heldenreise, und eine Note zu vergeben. Wir haben es nicht getan, aus demselben Grund, aus dem unser Gesetzgebungs-Tracker keine Fortschrittsbalken hat: Ein Roman hat keine definierten hundert Prozent. Ein Kammerspiel darf flach aussehen. Ein Thriller darf ein Sägezahn sein. Andrew Reagans Analyse von 1.327 Geschichten aus dem Project Gutenberg, aus der die „sechs Grundformen“ von Geschichten stammen, zeigt genau das: Es gibt mehrere Formen, die funktionieren, nicht eine.
Was trägt, sind wenige konkrete Beobachtungen, deterministisch berechnet, jede mit Kapitelangabe:
- Eine flache Strecke von drei oder mehr Kapiteln ohne Anstieg.
- Ein Abwärtstrend seit dem bisherigen Hoch, bei einem unfertigen Buch als Warnung formuliert: Geht es so weiter, droht ein Durchhängen in der Mitte, oder, wenn der Schluss schon in Sicht ist, ein Abfall zum Ende.
- Ein Tal zwischen zwei Hochpunkten, bei fertigen Teilen.
- Der bisher stärkste Punkt im ersten Drittel des geplanten Buchs, genannt mit der Zahl der Kapitel, die noch kommen und dagegen bestehen müssen.
- Eine durchgehend stille Achse, als Eigenschaft des Buchs, nicht als Fehler.
- Wenige offene Kapitelenden, und, erst wenn siebzig Prozent geschrieben sind, mehr eröffnete als aufgelöste Fäden. Mittendrin sind offene Fäden der Zweck des Buchs.
Das Vokabular für Wendepunkte, das wir dabei im Hinterkopf haben, stammt aus der Filmwissenschaft: Pinelopi Papalampidi und Kollegen haben 2019 fünf Wendepunkt-Typen definiert und ihre erwartete Position im Verlauf gemessen, Gelegenheit, Planänderung, Punkt ohne Wiederkehr, großer Rückschlag, Höhepunkt. Eine Beobachtung wie „der Höhepunkt liegt bei 25 Prozent“ ist in dieser Sprache gedacht.
Was die Kurve nicht kann
Drei Dinge sagen wir lieber selbst, bevor jemand sie entdeckt.
Die Kurve zeigt, was im Text angelegt ist, nicht, was ein Leser fühlt. Das ist der Befund von Matlin, und wir umgehen ihn nicht, wir arbeiten in seinen Grenzen. Zwei Lektoren, die dieselben Szenen auf „gefährlich oder nicht“ markieren, sind sich nach einer Würzburger Studie an deutschen Romanen (Albin Zehe, Julian Schröter, Andreas Hotho, 2023) nur in etwa sechs von zehn Fällen über den Zufall hinaus einig. Mehr Präzision als zwei Menschen darf eine Maschine nicht behaupten, und die Kurve tut es nicht. Deshalb steht unter dem Panel ein Satz, der sagt, wie gerechnet wird.
Das Modell sieht ein Kapitel und die Zusammenfassung des vorherigen, nicht das ganze Buch. „Verwehrtes Begehren“ erkennt es nur, wenn das Begehren im Kapitel oder in der Zusammenfassung steht. Für Fäden, die sich über zehn Kapitel spannen, ist der Story Atlas zuständig, und seine Zählungen fließen in die Entwicklungslinie ein, nicht in die Spannung.
Und: Die Schwellen, ab wann eine Strecke „flach“ ist oder ein Abfall ein „Trend“, sind gesetzt, nicht geeicht. Eine Eichung auf handmarkierten Kapiteln aus drei bis vier Romanen steht aus; das ist der nächste Schritt, und wir werden berichten, was dabei herauskommt. OpenAI schreibt in seiner Dokumentation ausdrücklich, dass Schwellen aus eigenen gelabelten Beispielen kommen sollten. Wir nehmen das wörtlich.
Für die Technisch-Neugierigen
Gespeichert werden nur die Rohantworten des Modells, pro Kapitel, unter dem Hash des Kapiteltexts und der Version des Fragenkatalogs. Jeder Wert, den du siehst, entsteht beim Lesen: Achsen, Tempo, Entwicklung, Positionen, Beobachtungen. Ändern wir ein Gewicht, ändert sich die Kurve jedes Buchs beim nächsten Öffnen, ohne einen Modellaufruf. Trifft der Story Atlas später ein, wird er sofort mitgezählt. Ändert sich ein Kapitel, wird nur dieses neu befragt; beim Abschließen eines Kapitels passiert das von selbst, im Hintergrund, nach der Zusammenfassung.
Die Glättung der Linie ist übrigens eine monotone kubische Interpolation und keine Catmull-Rom-Kurve. Letztere sah hübscher aus und tauchte bei einem Sprung von 54 auf 4 unter die Grundlinie. Eine Kurve, die unter null geht, hat ein Lügenproblem.
Literatur
- Glenn Matlin et al.: Do Language Models Agree with Human Perceptions of Suspense in Stories? COLM 2025. arXiv:2508.15794
- David Wilmot, Frank Keller: Modelling Suspense in Short Stories as Uncertainty Reduction over Neural Representation. ACL 2020. ACL Anthology
- Albin Zehe, Julian Schröter, Andreas Hotho: Towards a Computational Analysis of Suspense: Detecting Dangerous Situations. 2023. arXiv:2305.06818
- Pinelopi Papalampidi, Frank Keller, Mirella Lapata: Movie Plot Analysis via Turning Point Identification. EMNLP 2019. ACL Anthology
- Yufei Tian et al.: Are Large Language Models Capable of Generating Human-Level Narratives? 2024. arXiv:2407.13248
- Olivier Toubia, Jonah Berger, Jehoshua Eliashberg: How quantifying the shape of stories predicts their success. PNAS 2021. doi:10.1073/pnas.2011695118
- Semantic Novelty at Scale: Narrative Shape Taxonomy and Readership Prediction in 28,606 Books. 2026. arXiv:2602.20647
- Ryan L. Boyd, Kate G. Blackburn, James W. Pennebaker: The narrative arc: Revealing core narrative structures through text analysis. Science Advances 2020. doi:10.1126/sciadv.aba2196
- Andrew J. Reagan et al.: The emotional arcs of stories are dominated by six basic shapes. EPJ Data Science 2016. doi:10.1140/epjds/s13688-016-0093-1
- OpenAI: Decisions API (Dokumentation). developers.openai.com
- JEV vs. LLMs as Rubric Judges: Cheaper, Faster, and Wrong in the Same Places. 2026. arXiv:2609.29769
Häufig gestellte Fragen
Für welche Bücher gibt es die Spannungskurve?
Für Romane und Erzählungen. Bei Sachbüchern, Whitepapern und Seminarunterlagen zeigt der Editor keine Kurve; dort wäre „Konflikt zwischen Figuren“ keine sinnvolle Frage.
Kostet die Spannungskurve etwas?
Nein. Sie ist in jedem Buch enthalten. Ein Kapitel wird nur dann neu befragt, wenn sich sein Text geändert hat.
Wann wird die Kurve berechnet?
Beim Öffnen eines Buchs, dessen Kurve fehlt oder veraltet ist, von selbst im Hintergrund; beim Abschließen eines Kapitels; und per Knopf im Panel, der nur geänderte Kapitel neu analysiert.
Warum zeigt die Kurve keine Note oder Idealkurve?
Weil ein Roman keine definierten hundert Prozent hat. Ein ruhiges Kammerspiel und ein Thriller sind verschiedene Formen, nicht bessere und schlechtere. Die Kurve zeigt den Verlauf und nennt wenige konkrete Beobachtungen; die Entscheidung bleibt bei dir.
Was ist ein Decision Model?
Ein KI-Modell, das keine Texte schreibt, sondern typisierte Fragen (ja/nein, Auswahl, Stufe) mit einer kalibrierten Wahrscheinlichkeit beantwortet, in einem Durchgang. Hermes nutzt die Decisions API von OpenAI über HybridAI mit europäischer Verarbeitung, um die Spannungsfragen zu einem Kapitel zu beantworten.
Sieht das Modell mein ganzes Buch?
Nein. Es sieht das jeweilige Kapitel und die Zusammenfassung des vorherigen. Fäden, die sich über viele Kapitel spannen, zählt der Story Atlas.